Reconocimiento de postura humana en tiempo real a través de visión por computadora
TensorFlow y PoseNet sobre una señal de vídeo
- Publicado
- Actualizado
- (creado )
- Escrito por
- Willem L. Middelkoop
- Temas
- arte · datos · experimento · juego · gente · sensores · trabajo
- Versión humana de este artículo
- https://willem.com/es/2019-12-01_reconocimiento-de-postura-humana-en-tiempo-real-a-traves-de-vision-por-computadora/
- English
- Realtime human pose recognition through computer vision
- Nederlands
- Realtime herkenning van menselijke houdingen via computervisie
- Deutsch
- Echtzeit-Menschliche Posenerkennung durch Computer Vision
- Français
- Reconnaissance de la posture humaine en temps réel grâce à la vision par ordinateur
- Italiano
- Riconoscimento della posa umana in tempo reale con la computer vision
- Português
- Reconhecimento de poses humanas em tempo real com visão computacional
- Papiamentu
- Rekonosimentu di postura humano na tempu real via vishon di kompiuter
- Frysk
- Realtime werkenning fan minsklike hâldingen mei kompjûterfisy
- Idiomas
- Traducido del original en inglés por un modelo de lenguaje en dos pasadas (traducción y corrección) con un glosario y un corrector ortográfico; aún no revisado por un hablante nativo.
Resumen
Para un nuevo proyecto muy emocionante he estado experimentando con visión artificial usando TensorFlow. Quería conseguir detección de la pose humana en tiempo real para manejar proyecciones de vídeo interactivas y juegos. ¡Toca sumergirse en el mundo del aprendizaje automático, los tensores y la visión artificial!
Texto completo
Visión artificial
Lo que de verdad me apasiona es el campo científico interdisciplinar de la visión artificial, que estudia cómo hacer que los ordenadores alcancen una comprensión de alto nivel a partir de imágenes digitales y señales de vídeo. Incluye retos como adquirir, procesar y analizar imágenes digitales. Al final quieres que el ordenador tome decisiones basadas en su comprensión del (complejo) mundo que lo rodea.
TensorFlow
TensorFlow es una plataforma de código abierto de extremo a extremo para el aprendizaje automático, desarrollada originalmente por Google. Se apoya en el trabajo científico de varios investigadores y, desde entonces, se ha convertido en un ecosistema estable y robusto de herramientas, bibliotecas y recursos de la comunidad.
El nombre "TensorFlow" viene del concepto de un "flujo de tensores". Un tensor se describe mejor como una "cosa": algo que el ordenador ha reconocido o intenta analizar. Técnicamente, un tensor es una matriz multidimensional de valores numéricos. Eso permite al ordenador comparar "cosas" distintas y ver en qué se parecen (o se diferencian) sus características.
El principal reto del procesamiento de imágenes en tiempo real es reducir la complejidad de la imagen a trozos manejables que se puedan expresar como tensores. Normalmente el algoritmo de visión artificial consta de muchos pasos: reconocer una forma, recortar esa forma concreta, cambiarle el tamaño, quitarle el color, comparar los contornos, etc. Los tensores fluyen por estos pasos, de "sin analizar" a "reconocido". De ahí el nombre TensorFlow.
Potencia de cálculo
Lo bueno del aprendizaje automático moderno con TensorFlow es que, por lo general, no necesitas hardware (muy) caro para conseguir resultados. Esto se debe a que el "trabajo pesado" se hace al entrenar los modelos, que puedes imaginarte más o menos como "tablas de referencia". Esos modelos se crean analizando conjuntos de datos conocidos, en los que el ordenador recibe la "respuesta" y determina las características del objeto. Entrenar modelos requiere tiempo, potencia de cálculo y datos de entrenamiento.
Datos de entrenamiento
Google hizo algo realmente inteligente: repartió el entrenamiento de sus modelos de aprendizaje automático entre todos nosotros. ¡Sí, también entre tú!
reCAPTCHA
Seguro que te has topado con "reCAPTCHA". Es ese reto visual que tienes que superar cuando compras algo online o intentas registrarte en algún sitio. Protege a los dueños de tiendas online y sitios web contra los bots de spam, y su objetivo es distinguir a las personas de los bots. Para ello muestra imágenes (complejas) a las personas y les pide que identifiquen objetos en ellas: señales de tráfico, pasos de peatones, coches, etc. Google utiliza esta respuesta humana para entrenar sus modelos.
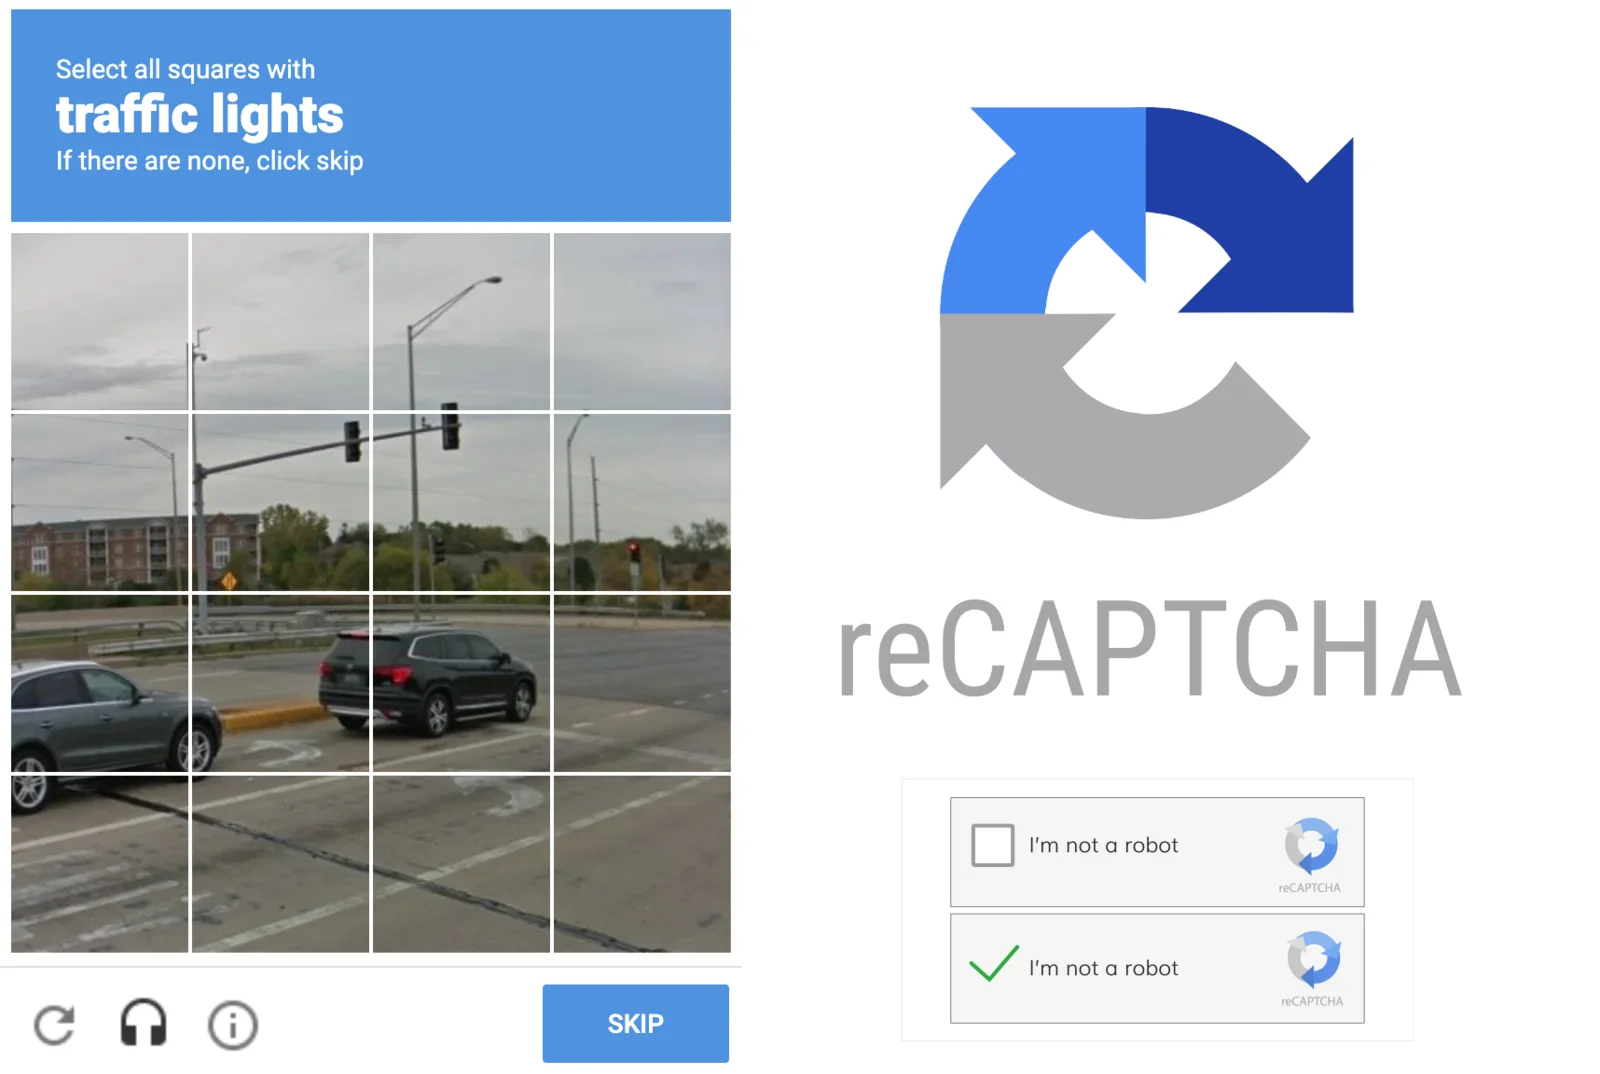
Lo mejor es que muchos de los hallazgos de Google se publican abiertamente. Hay un montón de proyectos de código abierto interesantes que nos permiten a los simples desarrolladores hacer cosas increíbles con el aprendizaje automático.
Reconocimiento de la pose humana con PoseNet
Uno de esos modelos de aprendizaje automático disponibles es PoseNet. Es un modelo de visión que sirve para estimar la pose de una persona en una imagen o un vídeo. Lo hace determinando dónde están las articulaciones clave del cuerpo: los codos, las manos, las caderas, las rodillas, los tobillos, etc.
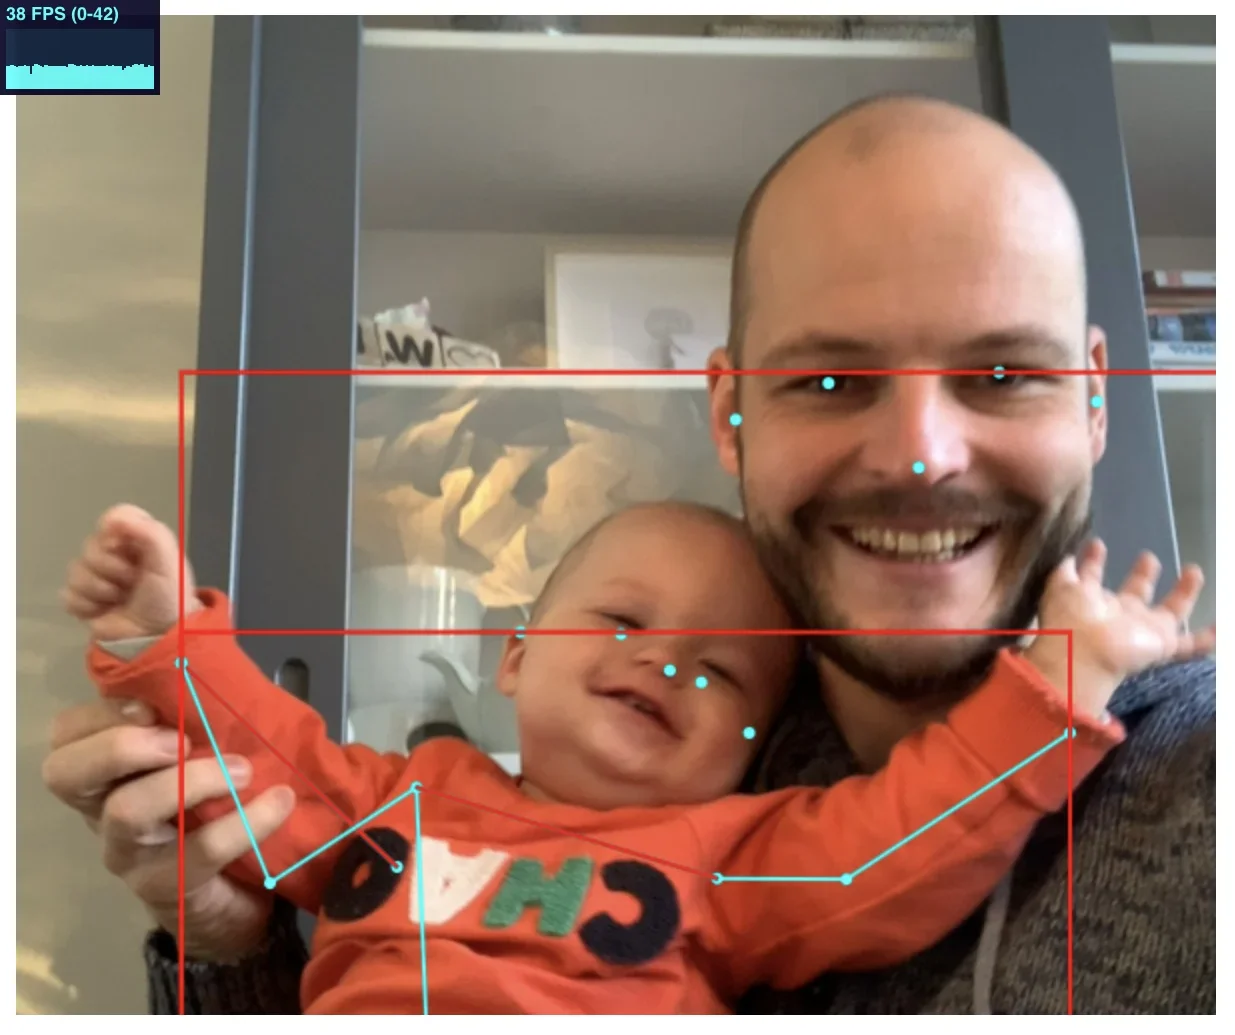
El algoritmo Single Shot MultiBox Detector (SSD)
El Single Shot MultiBox Detector es un algoritmo muy popular para detectar objetos en imágenes y señales de vídeo. Es popular por su velocidad. El principio es relativamente fácil de entender: el algoritmo intenta reducir la complejidad de la imagen lo antes posible y solo hace análisis profundos sobre mapas de características reducidos y simplificados.
Este enfoque funciona mejor para detectar objetos grandes, porque destacan enseguida y generan suficientes características de alto nivel para hacer predicciones en una fase temprana del algoritmo. Es ideal para detectar cuerpos, uno de los primeros pasos cuando quieres determinar poses humanas (primero miras dónde está una persona y luego cuál es su pose).
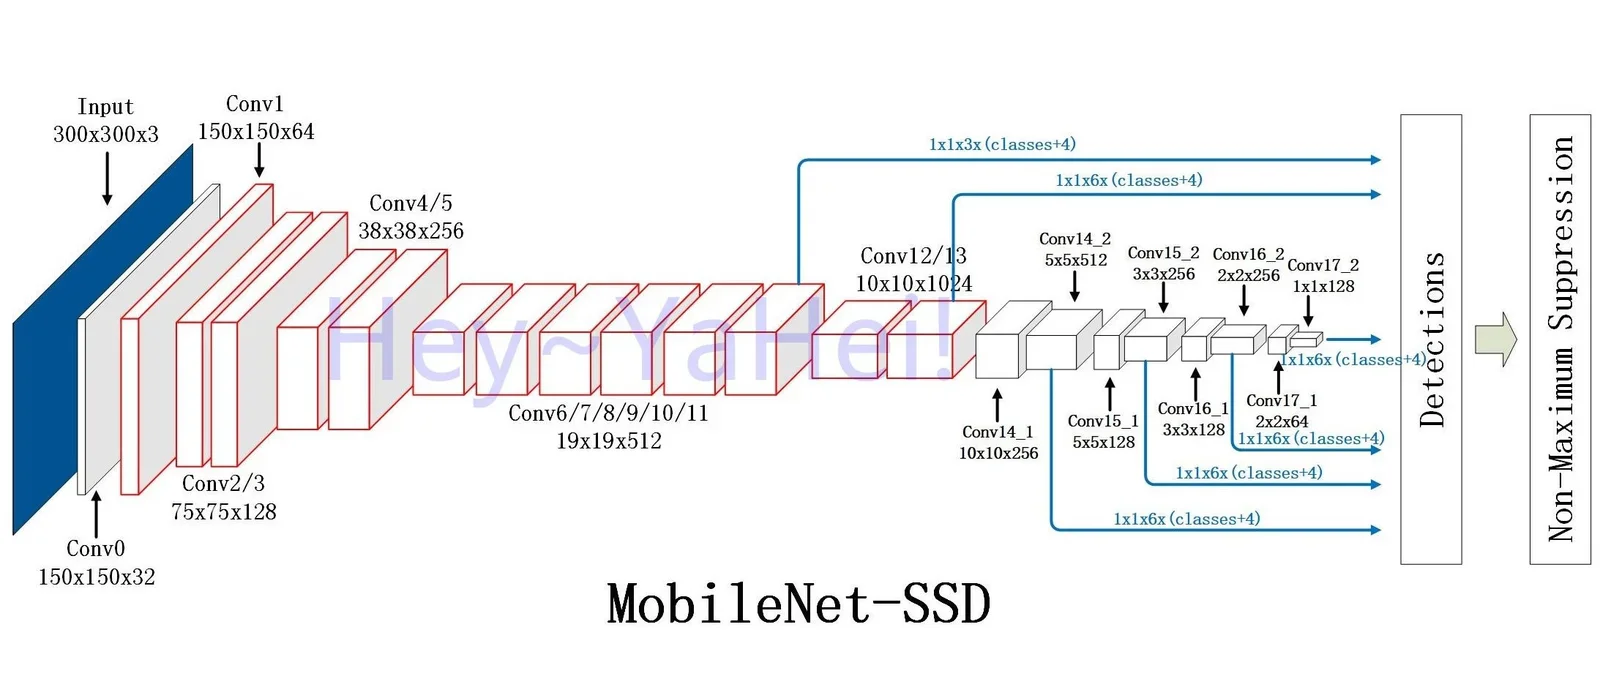
En el reconocimiento de imágenes y personas, la gente de China es bastante buena, por varias razones. Sus algoritmos rinden bien en hardware relativamente modesto. Gracias a eso, la visión artificial funciona bien en todo tipo de dispositivos, ¡y en tiempo real!
Casos de uso geniales
Poder detectar poses en tiempo real abre la puerta a todo tipo de cosas geniales. ¡Puedes convertirte, literalmente, en el mando del juego o en la entrada de una instalación de arte interactiva!
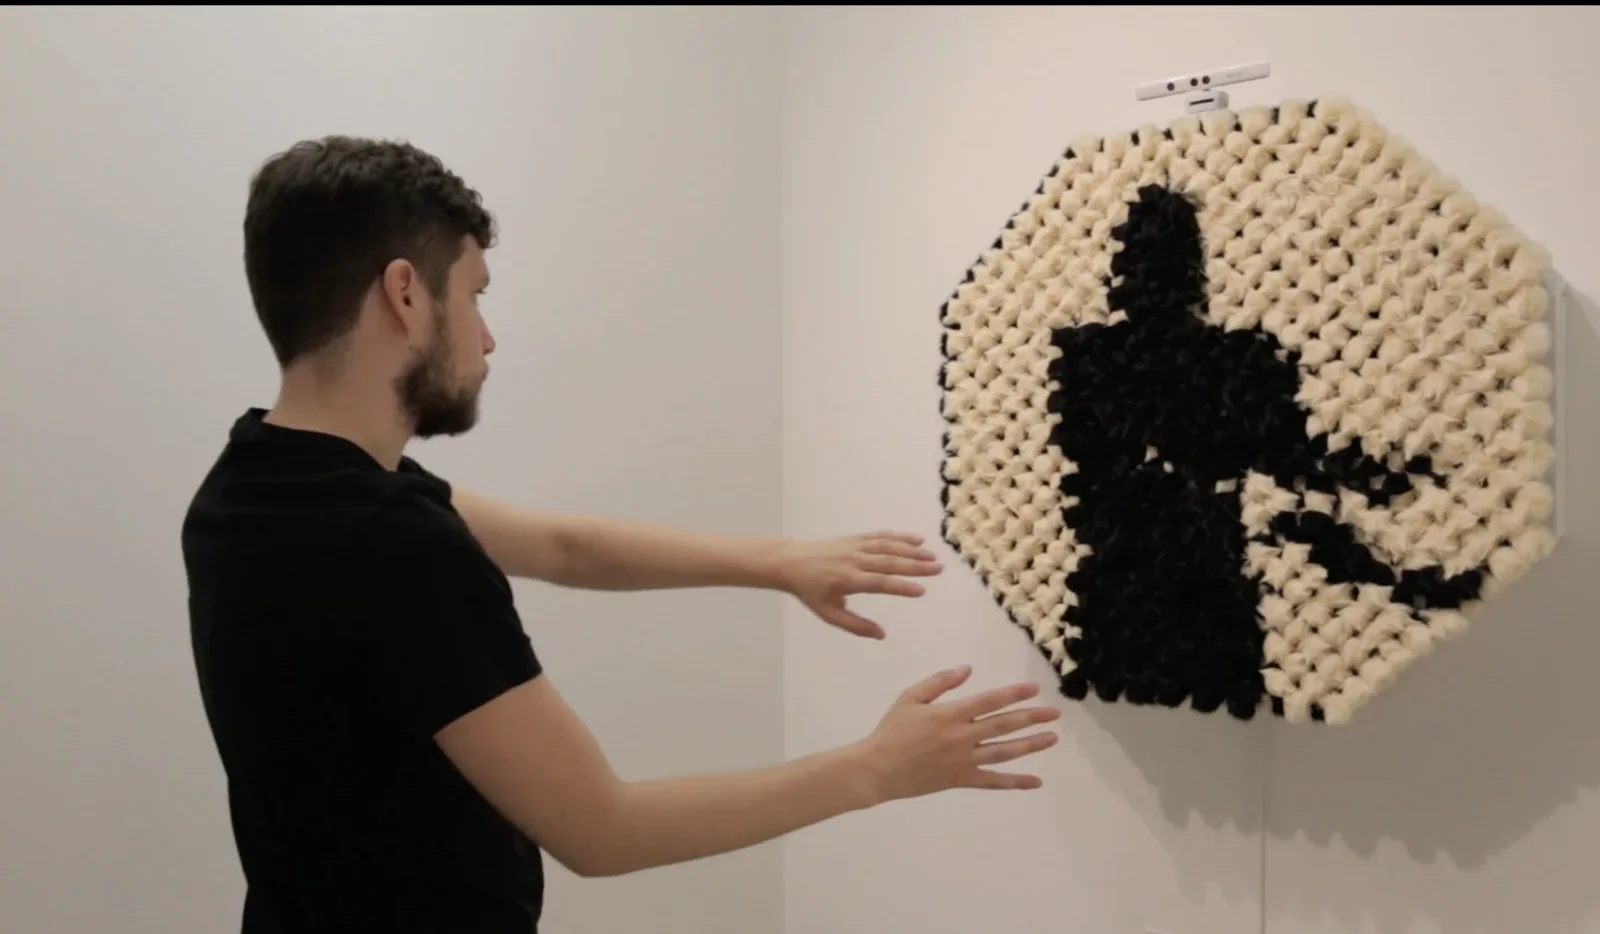
Espejo PomPom
Con 928 pompones esféricos de pelo sintético, esta instalación artística de Daniel Rozin es alucinante. La escultura la controlan cientos de motores que construyen siluetas de los espectadores mediante visión artificial.
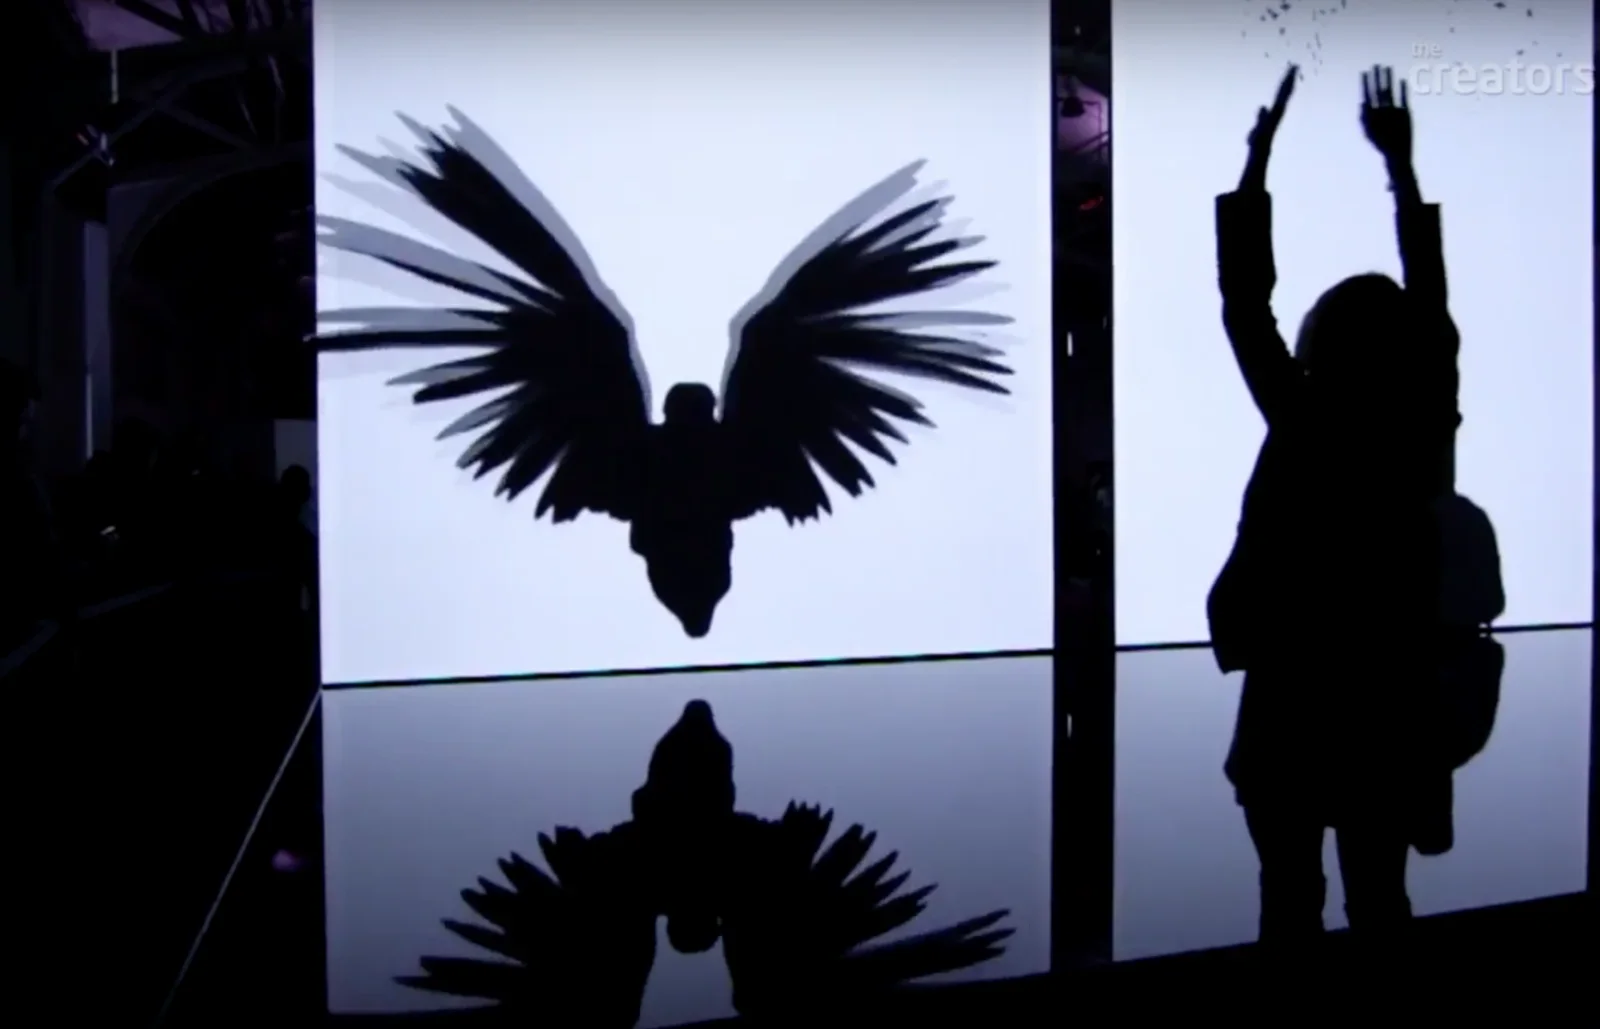
Convertirte en pájaro: The Treachery of Sanctuary
Hacer que la gente se pierda por un momento solo fue posible juntando disciplinas distintas. Esta impresionante instalación de arte interactiva dirigida por Chris Milk es un tríptico gigante que lleva a los espectadores por varias etapas del vuelo mediante visión artificial.
Conclusión
Trabajar en proyectos creativos y experimentales es un privilegio increíble, y es lo que hace que mi trabajo sea tan emocionante.
Con cantidades de datos cada vez mayores, dar sentido a todo ello de forma digital y autónoma es un gran reto de futuro, ¡y uno en el que tengo muchas ganas de trabajar!