Reconhecimento de poses humanas em tempo real com visão computacional
TensorFlow e PoseNet numa transmissão de vídeo
- Publicado
- Atualizado
- (criado )
- Escrito por
- Willem L. Middelkoop
- Temas
- arte · dados · experiência · jogo · pessoas · sensores · trabalho
- Versão humana deste artigo
- https://willem.com/pt/2019-12-01_reconhecimento-de-poses-humanas-em-tempo-real-com-visao-computacional/
- English
- Realtime human pose recognition through computer vision
- Nederlands
- Realtime herkenning van menselijke houdingen via computervisie
- Deutsch
- Echtzeit-Menschliche Posenerkennung durch Computer Vision
- Español
- Reconocimiento de postura humana en tiempo real a través de visión por computadora
- Français
- Reconnaissance de la posture humaine en temps réel grâce à la vision par ordinateur
- Italiano
- Riconoscimento della posa umana in tempo reale con la computer vision
- Papiamentu
- Rekonosimentu di postura humano na tempu real via vishon di kompiuter
- Frysk
- Realtime werkenning fan minsklike hâldingen mei kompjûterfisy
- Idiomas
- Traduzido do original em inglês por um modelo de linguagem em duas passagens (tradução e revisão) com um glossário e um corretor ortográfico; ainda não revisto por um falante nativo.
Resumo
Para um projeto novo e emocionante, tenho andado a experimentar visão computacional com o TensorFlow. Queria conseguir detetar poses humanas em tempo real, para comandar projeções de vídeo interativas e jogos. Chegou a altura de mergulhar no mundo da aprendizagem automática, dos tensores e da visão computacional!
Texto completo
Visão computacional
O que me entusiasma a sério é o campo científico interdisciplinar da visão computacional, que estuda como é que os computadores podem chegar a uma compreensão de alto nível a partir de imagens digitais e transmissões de vídeo. Inclui desafios como adquirir, processar e analisar imagens digitais. No fim, o que queres é que o computador tome decisões com base na compreensão que tem do (complexo) mundo à sua volta.
TensorFlow
O TensorFlow é uma plataforma de código aberto, de ponta a ponta, para aprendizagem automática, desenvolvida originalmente pela Google. Assenta no trabalho científico de vários investigadores e tornou-se entretanto um ecossistema estável e robusto de ferramentas, bibliotecas e recursos da comunidade.
O nome «TensorFlow» vem da ideia de um «fluxo de tensores». Um tensor descreve-se melhor como uma «coisa», algo que o computador reconheceu ou tenta analisar. Tecnicamente, um tensor é uma matriz multidimensional de valores numéricos. Isto permite ao computador comparar «coisas» diferentes e ver até que ponto as suas características se parecem (ou não).
O grande desafio do processamento de imagem em tempo real é reduzir a complexidade da imagem a pedaços processáveis, que se possam exprimir como tensores. Normalmente isto implica muitos passos no algoritmo de visão computacional. Passos como reconhecer uma forma, recortar essa forma, redimensioná-la, tirar-lhe a cor, comparar os contornos, etc. Os tensores fluem por estes passos, de «não analisado» a «reconhecido», daí o nome TensorFlow.
Poder de processamento
O melhor da aprendizagem automática moderna com o TensorFlow é que, em geral, não precisas de hardware (muito) caro para obter resultados. Isto acontece porque o «trabalho pesado» é feito ao treinar os modelos de aprendizagem automática, que podes imaginar mais ou menos como «tabelas de referência». Estes modelos são criados a partir da análise de conjuntos de dados conhecidos, em que o computador recebe a «resposta» e determina as características do objeto. Treinar modelos exige tempo, poder de processamento e dados de treino.
Dados de treino
A Google fez algo verdadeiramente inteligente: distribuiu o treino dos seus modelos de aprendizagem automática por todos nós. Sim, incluindo-te a ti!
Recaptcha
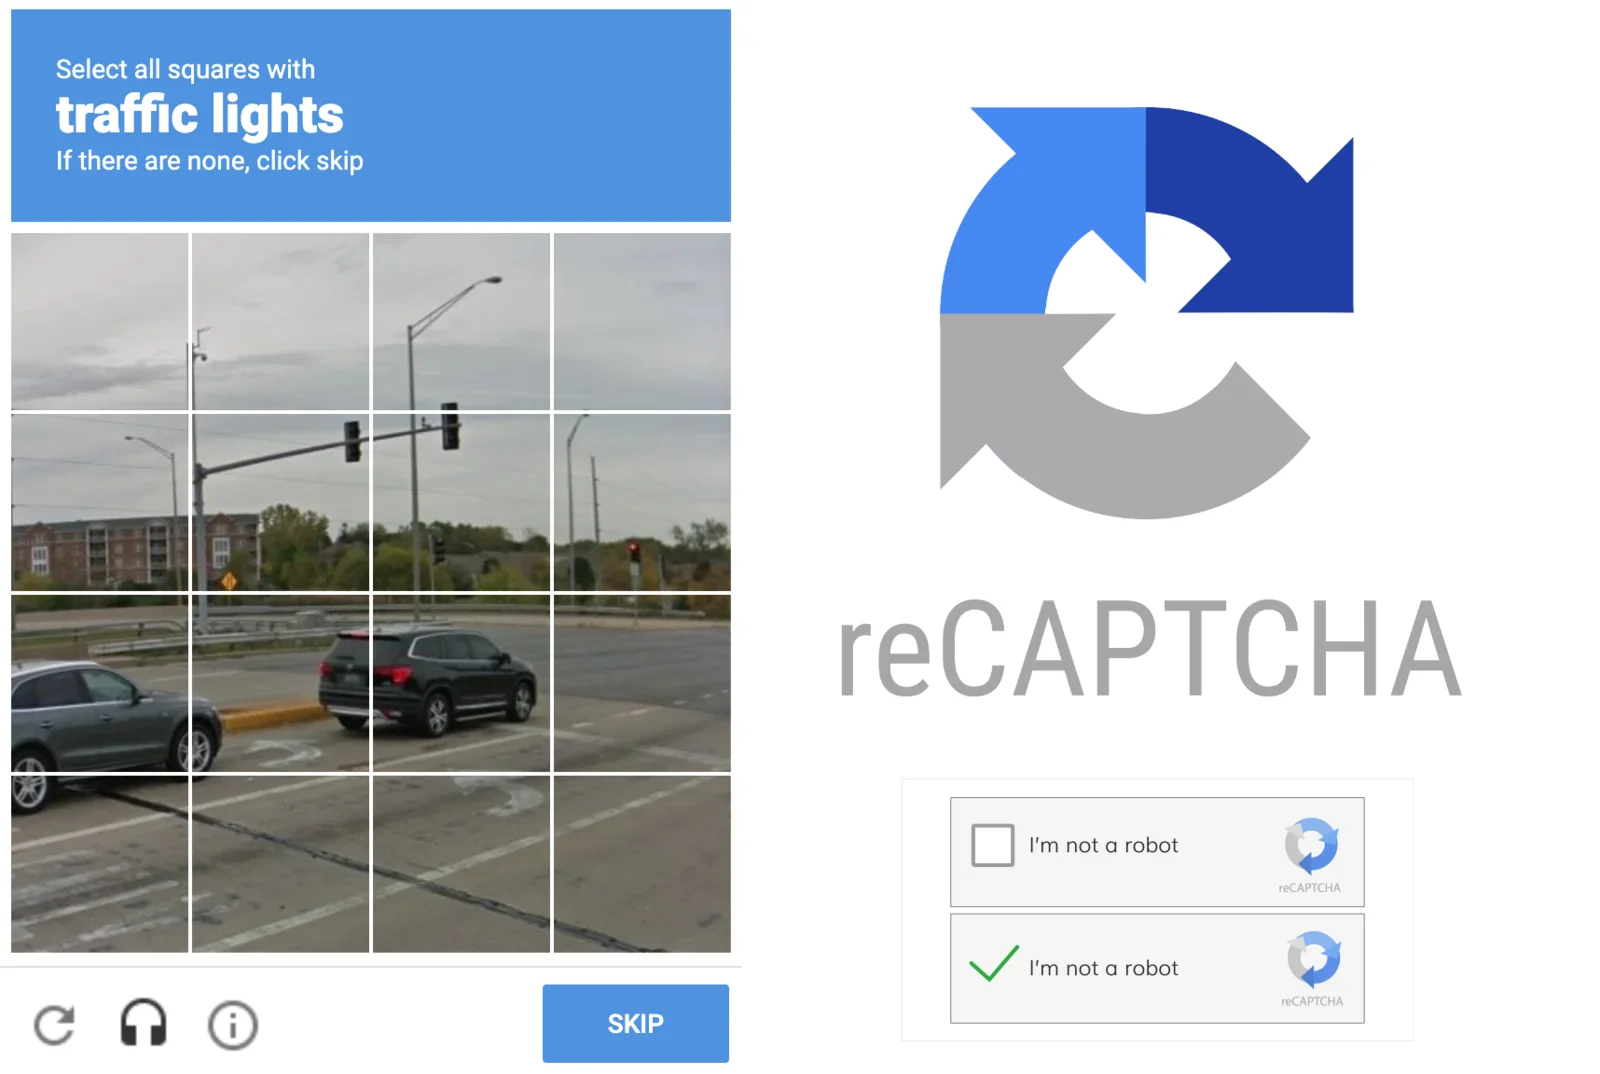
É bem possível que já tenhas encontrado o «reCAPTCHA» ou «Recaptcha». Um desafio visual que tens de completar quando compras algo online ou tentas registar-te nalgum sítio. Este desafio protege os donos de lojas online e de sites contra (spam)bots. O objetivo é distinguir humanos de robôs. Fá-lo ao mostrar aos humanos imagens (complexas) e ao pedir-lhes que identifiquem objetos nelas. Como sinais de trânsito, passadeiras, carros, etc. A Google usa este feedback humano para treinar os seus modelos.
O melhor é que muitas das descobertas da Google são tornadas públicas, e há imensos projetos de código aberto interessantes que nos permitem, a nós, programadores simples, fazer coisas incríveis com aprendizagem automática.
Reconhecimento de poses humanas com o PoseNet
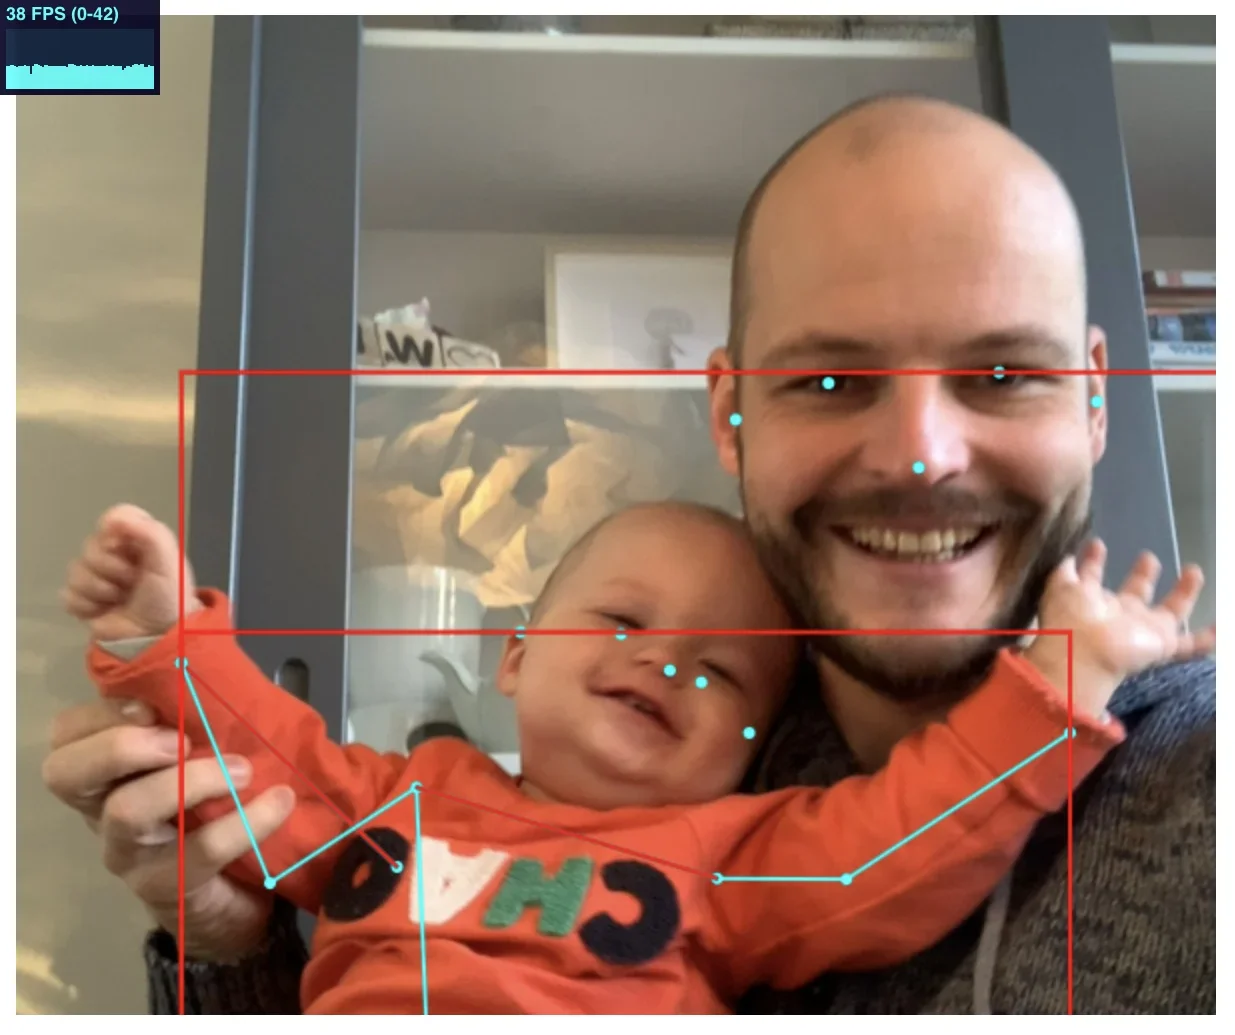
Um dos modelos de aprendizagem automática disponíveis é o PoseNet. É um modelo de visão que serve para estimar a pose de uma pessoa numa imagem ou num vídeo. Fá-lo ao determinar onde estão as articulações principais do corpo, como os cotovelos, as mãos, as ancas, os joelhos, os tornozelos, etc.
Algoritmo Single Shot MultiBox Detector (SSD)
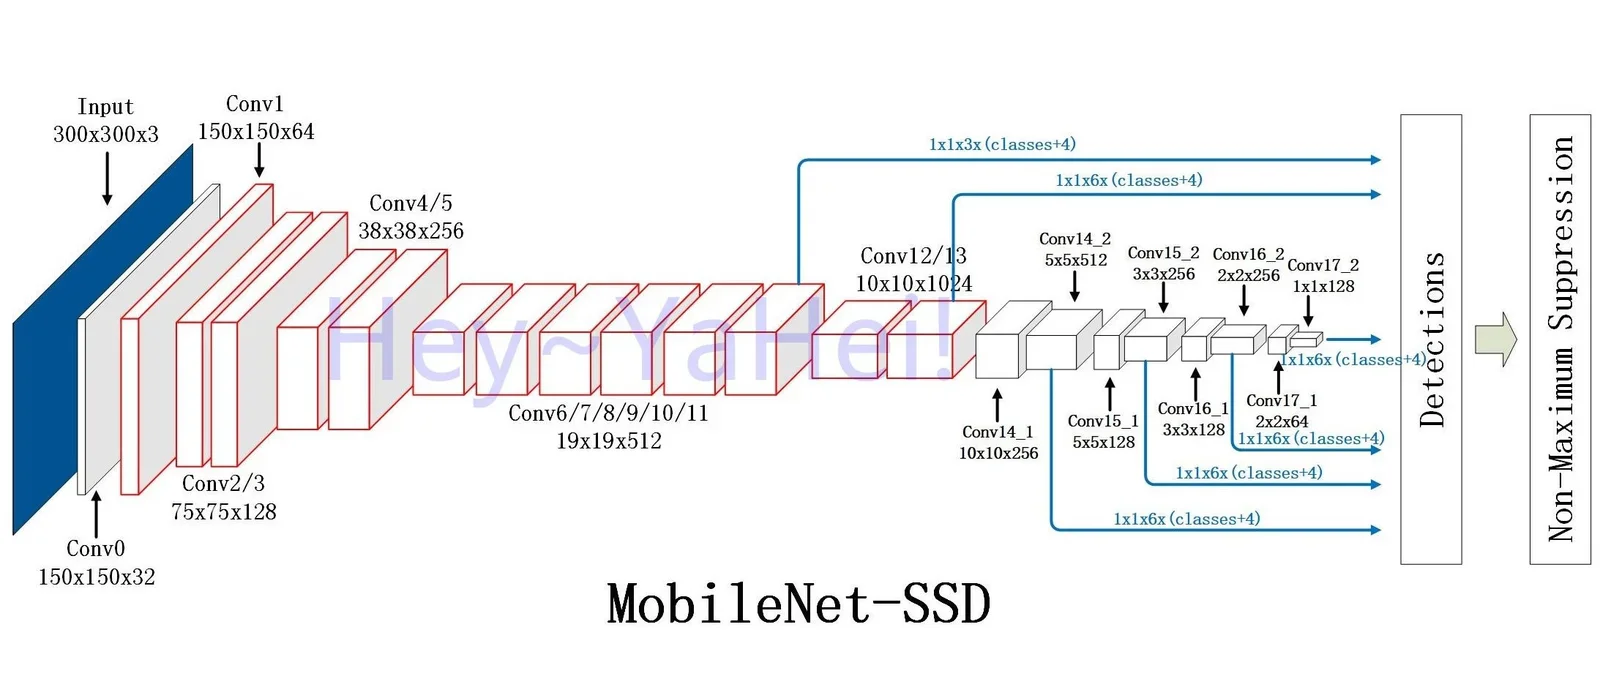
O Single Shot MultiBox Detector é um algoritmo popular para detetar objetos em imagens e transmissões de vídeo. É popular por causa da sua velocidade. O princípio é relativamente simples de perceber: o algoritmo tenta reduzir a complexidade da imagem o mais depressa possível e só faz análises profundas em mapas de características encolhidos e simplificados.
Esta abordagem funciona melhor quando queres detetar objetos grandes, porque se destacam depressa: geram características de alto nível suficientes para fazer previsões logo no início do algoritmo. Isto é ótimo para a deteção de corpos, que é um dos primeiros passos quando queres determinar poses humanas (primeiro vês onde está uma pessoa, depois qual é a pose dela).
O reconhecimento de imagens e de pessoas é uma área em que o pessoal da China é muito bom, por várias razões. Os algoritmos deles funcionam bem em hardware relativamente fraco. Isto permite que a visão computacional funcione bem em todo o tipo de dispositivos, em tempo real!
Casos de utilização fixes
Poder detetar poses em tempo real abre a porta a todo o tipo de coisas fixes. Tu podes, literalmente, tornar-te o comando do jogo ou o input de uma instalação de arte interativa!
Espelho PomPom
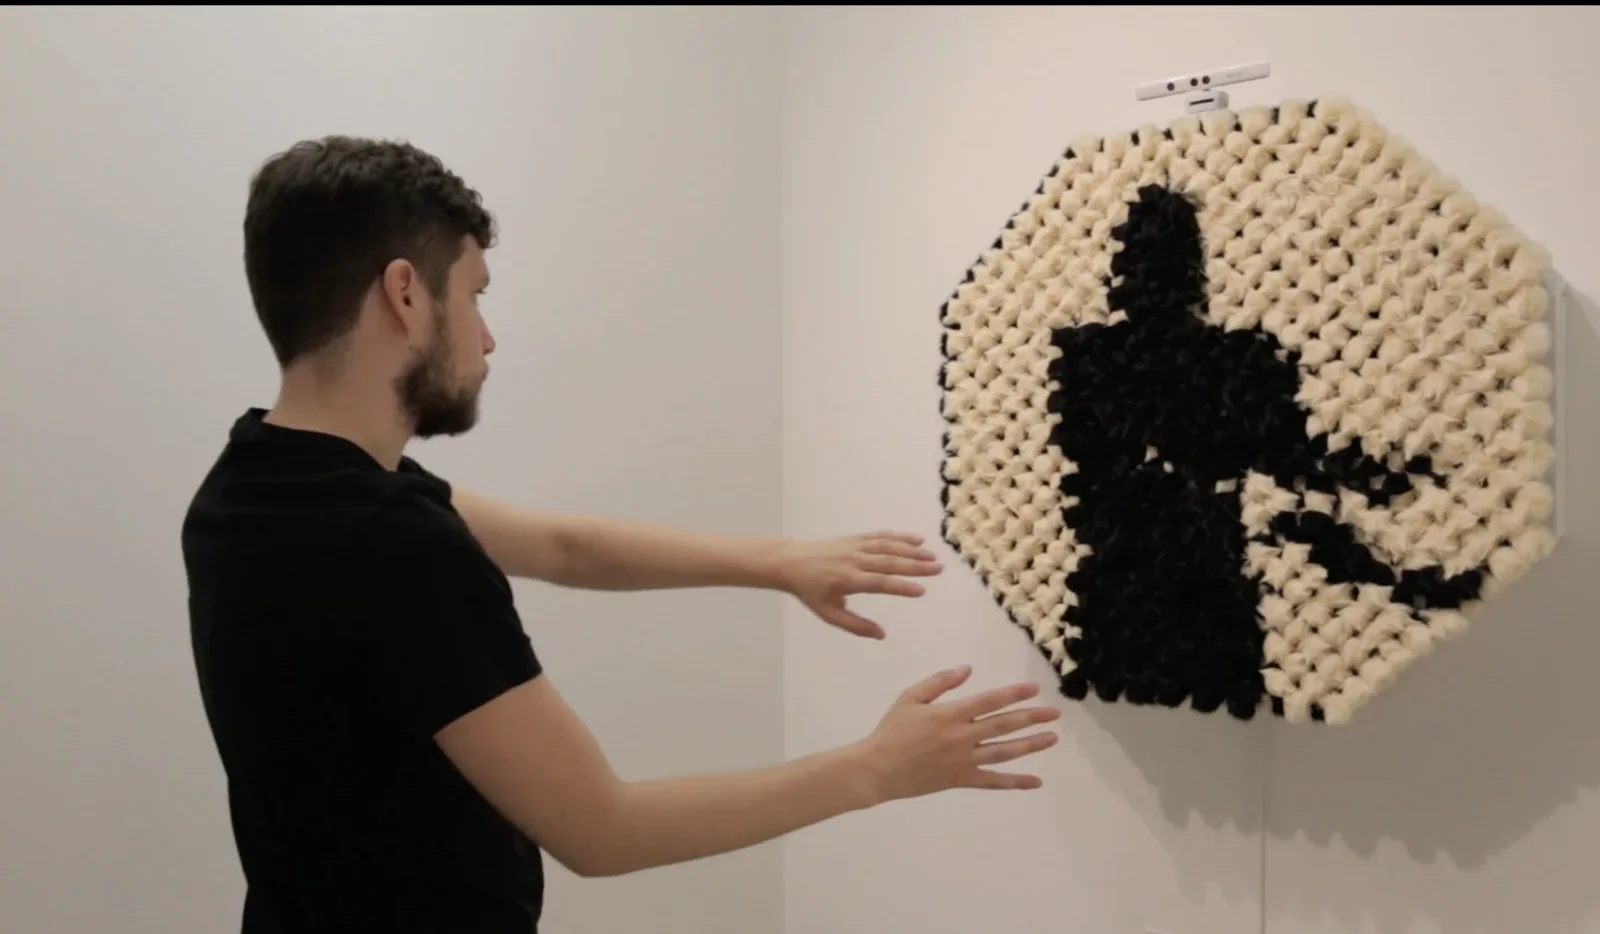
Com 928 pompons esféricos de pelo sintético, esta instalação de arte de Daniel Rozin é fantástica. A escultura é controlada por centenas de motores que formam silhuetas de quem a observa, através de visão computacional.
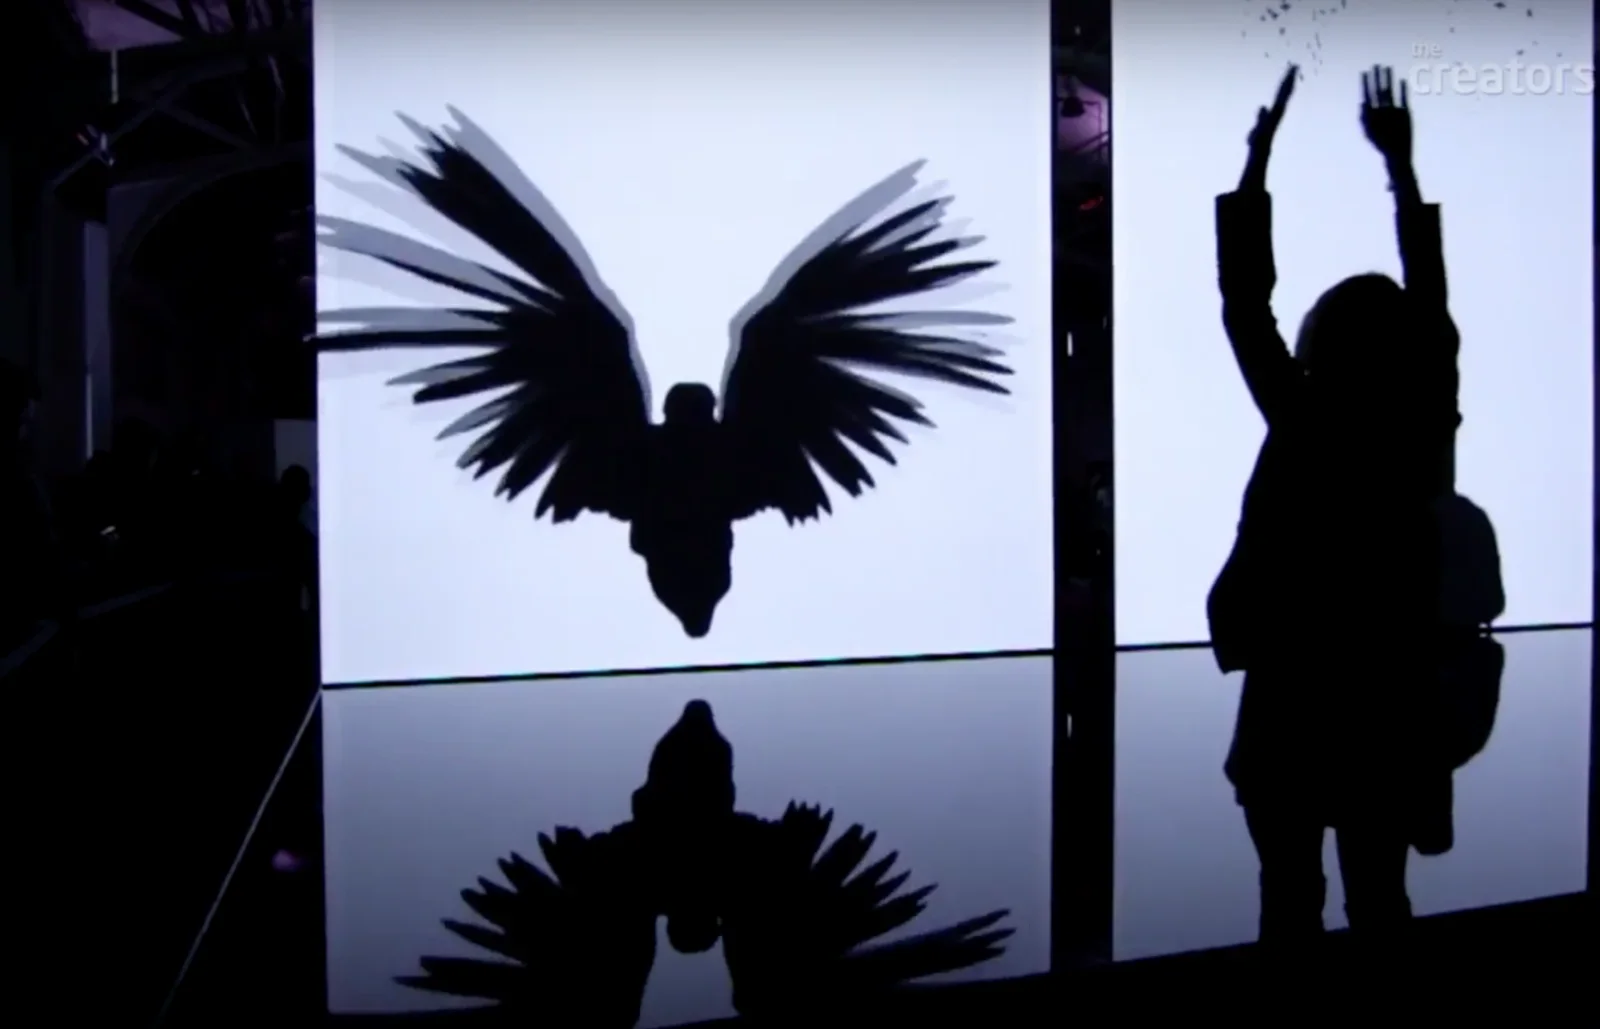
Transformar-te num pássaro: The Treachery of Sanctuary
Permitir que as pessoas se percam por um momento só foi possível juntando disciplinas diferentes. Esta incrível instalação de arte interativa dirigida por Chris Milk é um tríptico gigante que leva os visitantes por várias fases do voo, com recurso à visão computacional.
Conclusão
Trabalhar em projetos criativos e experimentais é um privilégio incrível, e é isso que torna o meu trabalho tão entusiasmante.
Com montanhas de dados cada vez maiores, dar sentido a tudo isto de forma digital e autónoma é um grande desafio para o futuro: e é um desafio no qual tenho muita vontade de trabalhar!